Nora 问答报错及原因排查
问答出现问题时,如何定位原因,是排查工作和优化工作的核心。本章从系统实现问答的原理讲起,理解一次提问在系统内部究竟经历了什么,再据此给出定位与解决问题的途径。
排查前,请先确保模型能够正常查看明细数据。若数据源连接异常,后续的定位工作将无法有效开展。
一、先理解系统是如何实现问答的
在定位问题之前,先大致了解下系统实现问答的原理,这样排查时才知道该看哪一环。
1. 系统学习了什么
系统会从模型中学习核心关键词,主要包括:
- Schema 名称、字段名称、字段同义词、自定义词汇、自定义指标;
- 语义类型为 名称、分类、标签 的字段,还会链接到数据库中对应列,学习其枚举值。
2. “学习”这个动作实际做了什么
点击学习时,系统实际完成的是一条向量化链路:
这些关键词或段落的向量会被写入系统元数据库,也就是部署时的 PostgreSQL(pg)数据库。关于 RAG 检索机制的细节,这里不做赘述。
3. 输入问题时发生了什么
当我们在问答框中输入问题时,本质上是向 LLM 发送了一段文本:
- 如果问的比较准确,借助系统核心算法 Alisa,就已经能够成功输出结论;
- 如果问的比较模糊,这个模糊词会被送入 Embedding 模型生成查询向量,再拿这个向量到 pgvector 做相似度检索;
- 最终选取相似度得分最高的向量,完成关键词召回。
二、系统运转流程
所有获取数据的问题,最终都会通过系统的核心服务 Alisa 解析得出答案。
因此会出现一个很常见的现象:我们问了一个涉及取数的问题,Alisa 解析后得到的问题,和我们最初的提问往往存在差异,它会将我们口语化的提问 标准化 成 Alisa 能够理解的问题,并和结论一起,以卡片的形式展示给我们。
定位问题,就是通过 Alisa 最终输出的问题来进行排查。
三、解决问题的途径
根据实际情况,选择更契合的解决路径:
其中,第二条途径(建模优化调整) 是本篇排查的重点。后面将先介绍如何定位问题,再展开说明定位到问题后,通过什么方式做建模优化调整。
四、问题归类
排查前先归类,定位时才能对症下药。当 Alisa 最终拿到的问题不符合预期时,问题通常落在以下三类之一:
下面逐一展开。
1. 元数据 & 术语匹配错误
这类问题的共同点是:提问中的词或值,没能对应到模型或数据库中的目标。有两种情况。
1.1 关键词不存在,未匹配到目标字段
数据里明明有这个词,提问后系统却提示“不理解”。可按顺序做两步验证。
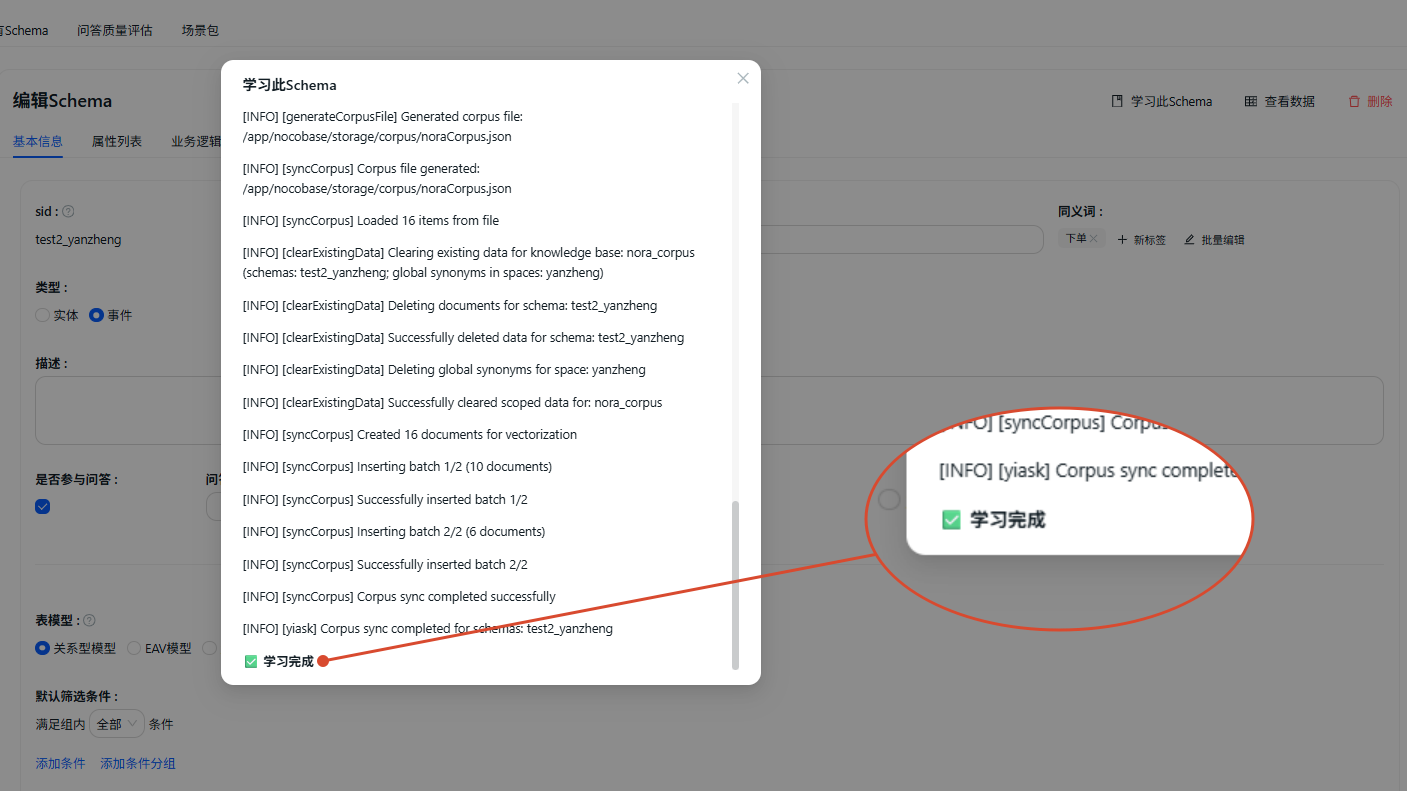
第一步:确认 Embedding 是否正常。 点击学习单个 Schema,拉到最后,观察能否成功学习。
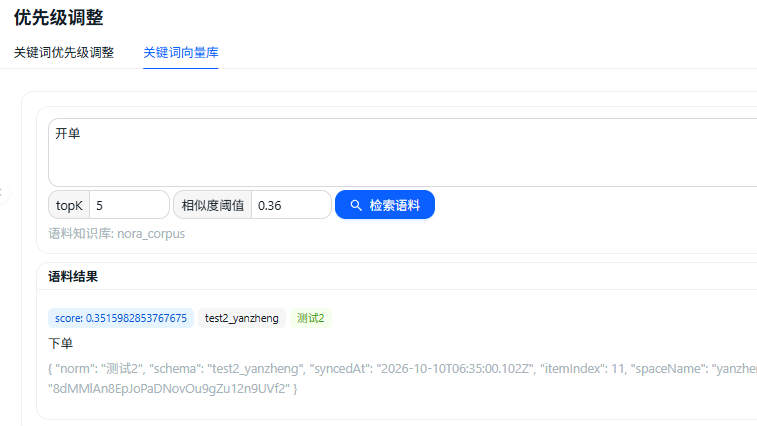
第二步:确认关键词是否已入库。 进入 系统搭建 → 知识库配置 → 问答优先级调整 → 关键词向量库 检索该词,页面会以 topK 的形式返回最相近的若干关键词。
典型案例:用户想统计订单量,提问“查询开单数量”,系统却提示未找到“开单数量”。根源在相似度——系统默认阈值为 0.25,而“开单”需要与“下单”的相似度超过 0.35 才能被召回,默认条件下自然无法命中。
为该词配置同义词——可在 Schema 模型中配置,也可在全局同义词中配置。建模初期多考虑一点,后续体验就会更顺滑。
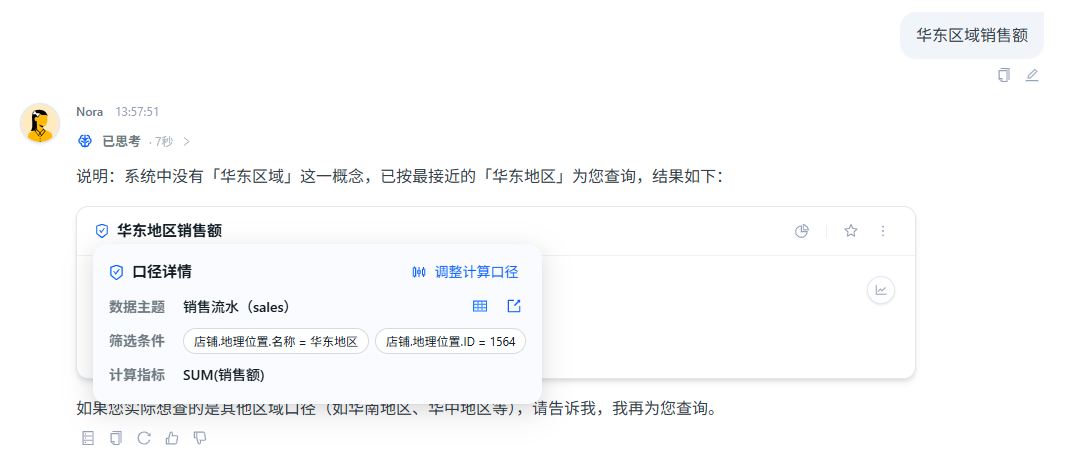
并非只要偏离就一定失败。例如提问“华东区域销售额”,数据里虽没有“华东区域”,却存了“华东大区”“华东地区”,系统仍能召回。也就是说,凡是被学习过的内容通常都能检索到;但向量带有打分机制,词偏离越大,命中的概率越低。
1.2 维度枚举值匹配失败
当用户问到的是数据库中的枚举值时,若该字段的语义类型是 ID 或字符串,它就不会被学习进向量库,因而无法匹配。可按场景选择处理方式:
2. 数据结果计算和实际不符
这类问题的表现是:数据取到了,但和预期对不上。建议由粗到细排查。
2.1 简单判断:查看计算口径
问题卡片左上方提供数据计算口径详情,列出了数据的计算来源与筛选逻辑,可据此初步定位——缺过滤条件就补过滤条件,数据源有问题就换数据源。点击调整计算口径,还能看到更多细节。
2.2 进阶判断:查看完整链路
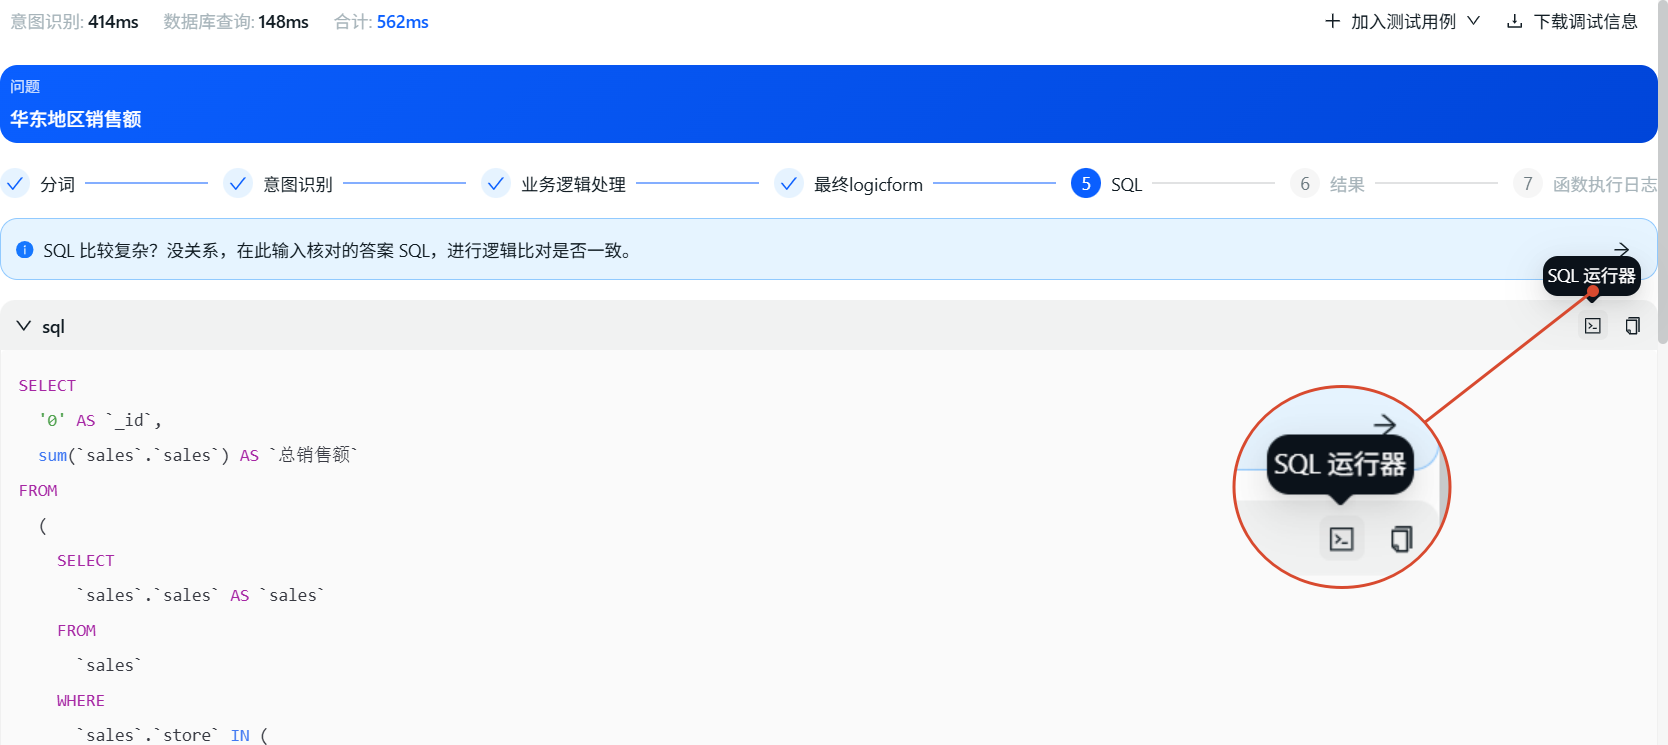
若口径仍看不出问题,点击卡片右上角更多(⋯)→ 调试,即可查看这个问题从分词 → 意图识别 → 生成 SQL → 输出结果的完整链路。其中 SQL 可以直接运行验证,定位起来更高效。
3. 多选一出现很多条目
待补充